Pytorch 的入门
深度学习简单入门
深度学习是机器学习的一种
相比于普通的机器学习,中间除了简易特征提取器外,包含额外特征提取层,因此对抗噪点的能力更强。
与普通的机器学习不同,除了输入与输出外,中间的部分 - 如简易特征提取器、额外特征提取层、学习器(即多层神经网络)- 整体是一个黑盒
入门视频推荐
权重与损失
以线形模型为例,在深度学习中,权重(即 一次函数的比例值
随机猜测(Random Guess):随机取一个值
作为线性模型 的权重 评估此权重的模型与数据集中的真实数据间的匹配程度
- 例如计算每个
通过当前权重预测 与真实值 的差值的平方,即通过方差判断,越小说明越匹配 此时选择的评判误差模型就是损失(loss),即 损失函数。在例子中,单个样本的损失计算为
此时的平均损失 $cost=mean=\frac{1}{N}\sum loss $,即
这里就是最简单的损失函数,均方差损失 MSE (Mean Square Error)
- 例如计算每个
通过不断调整,用梯度下降的方式,让损失函数计算出的值不断变小
深度学习本质上就是通过训练计算出合适的权重,使损失最小
当权重不止一个时,使用随机猜测需要猜测权重组合。假设1个权重时,猜测100种情况。2个权重则需猜测
梯度下降
由于维度诅咒的存在,不断更换权重,寻找损失最小的问题,被称为优化问题。当随机猜测一个权重后,计算出损失时,如何判断下一次权重应该取更大的值还是更小的值呢?
对于之前举例的单个权重参数的线性模型来说, 穷举不同权重可以得到的损失曲线,当选取最佳权重时,损失最小。往两边损失不断增大。因此可通过计算当前权重值下的斜率,即通过平均损失对权重求导
- 导数为正(
),说明当前 下损失是上升趋势, 需要减小才能让损失下降 - 导数为负(
),说明当前 下损失是下降趋势, 需要增大才能让损失下降
所以梯度实际上就是 cost 对
即每次迭代
对于其他模型(单个权重参数的线性模型,由之前的推导可知,是开口向上的抛物线)来说,损失随权重的变化曲线可能并不是两边高,中间低。若曲线有两个低点,且随机权重
将 式(2) 带入 式(3) 可得线形简单模型的梯度公式
对于线形的简单模型,单个样本的损失对权重求导为
随机梯度下降
在多维空间中,损失曲面上存在这样一种临界点:沿着某些参数方向看,它是最低点(向上弯曲);但沿着另一些方向看,它却是最高点(向下弯曲),形状酷似马鞍,即鞍点。在现代高维深度学习中,鞍点以及平坦高原的数量远远多于局部极小值点。
为什么传统全量梯度下降会卡住? 在严格的鞍点处,全量数据的真实梯度为零 (
因此出现了随机梯度下降。 这里的“随机”指每次从总数据集中随机抽取一小批(一个 Batch)样本来计算梯度并更新参数。通过 Mini-batch 的小批量随机抽样引入了天然的**“梯度噪声 (Gradient Noise)”。这种方向随机的随机扰动破坏了鞍点处的受力平衡,能够像外力震颤一样将参数“踢出”鞍点区域,使其顺利沿着下坡方向继续下降,从而有效逃离鞍点**。
- 如果是看全部数据:所有样本的拉力互相抵消,在鞍点处合力为 0,小球停住不动
- 但对于随机的一个 Batch,假设
batch_size = 64- 这个 Batch 里的 64 张图碰巧稍微偏向某一种特征,它算出来的合力就会往左晃一下;
- 下一个 Batch 算出来的合力又往右晃一下;
- 这种由于“随机样本抽样偏差”带来的轻微晃动(梯度噪声),正是把参数从鞍点的不稳定平衡中“推一把”、让它顺着下坡滚下去的关键动力!
关于 batch_size 的大小
- 当
batch_size = 1时 (Pure SGD)- 模型进行的是完全随机的梯度下降(Pure SGD)。由于每次仅依据单个样本计算梯度,每一步更新的波动极大,在参数空间中呈现出锯齿状或“醉汉漫步”般的剧烈震荡。
- 在线性回归的均方差(MSE)损失函数中,由于损失曲面是一个规则的凸椭圆抛物面(碗状)
- 虽然单步更新方向带有随机噪声,但在数学期望上始终指向抛物面底部的全局最优解; - 若保持较大的固定学习率,模型在接近谷底时容易在最优解附近持续徘徊震荡
- 但只要配合合理的学习率衰减策略(Learning Rate Decay),即使
batch_size = 1在理论与实践中也能够稳步收敛到最优解。 - 现代工程中避免
batch_size = 1的核心原因并非无法收敛,而是因为无法利用 GPU 矩阵并行算力,导致硬件吞吐效率极低。
- 在合理范围内增大 batch_size (Mini-batch)
- 硬件层面:充分打满 GPU/NPU 向量流水线,显著提高显存带宽和计算核心利用率
- 训练效率:单轮(Epoch)所需的更新迭代步数减小,全数据集整体跑完的物理耗时大幅缩短
- 梯度稳定性:梯度方差随着样本量增加而缩小,梯度的下山方向更稳定、准确,更新时的振荡幅度减小
- 当 batch_size 过大时 (Extreme Large Batch)
- 显存危机:激活值(Activation Maps)与批量数据占用显存呈线性激增,极易引发 OOM(显存溢出)
- 参数更新频率骤降:单个 Epoch 内的权重更新次数过少。若不配合增大基础学习率(如线性缩放原则 Linear Scaling Rule)及学习率预热(Warmup),模型收敛会极其缓慢
- 算力收益边际递减:当 Batch 达到一定量级后,进一步增大样本所带来的“梯度方向精度提升”微乎其微,消耗了成倍算力却收效甚微
- 泛化能力下降(核心痛点):由于失去了小批量抽样带来的适度“随机噪声”,模型极易陷进狭窄的**尖锐极小值(Sharp Minima)**中,导致在测试集上的泛化效果(真实准确率)明显低于小 Batch 训练出的模型
反向传播
在之前的介绍中,求出了线形的简单模型下,单个样本的损失对权重导数
实际的深度学习中,比如上一层6个节点,对于5个节点的全连接层来说,权重是
计算图
计算图(Computational Graph) 是深度学习和科学计算中用来描述数学计算过程的有向图
对于
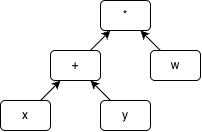
根据计算图,
此时如果计算
- 先计算
的对 下一层的偏导,即 - 再计算
的对 下一层的偏导,即 - 通过链式求导法则,可计算出
,因为
即可以通过链式的方式,一层层求导,实现最顶层对最底层的梯度计算。
对于神经网络的计算图来说,
最终,损失对于输出的值就可以通过反向传播进行计算了。
- 通过前向传播,计算每一步的值,并存储梯度
- 构建计算图
因此,在 Pytorch 中为了简化,默认在数据输入到网络中时会保存每一层的梯度。而推理过程由于不需要反向传播,因此可以不用保存梯度
激活函数
对于上一层 2 个节点,当前一个节点的全连接层
由于依然是线形关系,效果不好。为了优化效果,在全连接层中会在权重内添加一个非线形函数
添加非线形函数的操作被称为激活,添加的函数被称为激活函数
分类问题
之前讨论的都是连续线形回归模型。对于多分类问题来说,线形回归可能不是那么合适
例如 MNIST 数据集中,7 和 9 比 7 和 8 长的更相似,输入内容更接近,线形模型中输出也会更接近。但这样就没有意义
此时不应该根据输入去估算输出的具体内容,而是根据输入去评估每个分类的概率
对于连续线形回归来说,通过输入 1 得到2,输入2得到4...估算输入值的输出。而分类问题则是输入 1 得到 0,输入2得到0,输入3得到1...(此处是一个二分类)。此时最常用的就是 sigmoid 函数 Logistic Regression(逻辑蒂斯回归的西格玛函数)
此时,对于分类问题来说,之前介绍的损失计算方式(均方差损失)不再适用。分类问题中最常用的损失函数是交叉熵损失
在二分类情况下。在二分类问题中,使用输出结果与 Sigmoid 函数,让输出内容归于
在多分类下,当线形模型的输入值是含有多个权重的特征,比如 5 个特征,模型为
即 5 个输入,单个输出(上层5个节点,自身1个节点)的全连接层
softmax
在多分类输出下,不像二分类的输出,可能出现输出的每个分类可能性的和不为1,即可能性和不是 100%。需要 softmax 层将输出内容转换成真实的概率,即保持输出的每种分类的结果保持一定的竞争性
通过 softmax 层,将输出
即:例如当分成三种结果,输出内容为
在 torch 中,softmax 是隐形实现的,一般不需要手动声明
步骤
深度学习与监督学习都包含以下步骤
- 数据集的准备
- 模型
- 训练
- 推理(inferring) 即使用训练好的模型对新的输入推理出输出
过拟合
若训练集的数据分布不够全面,导致特征提取过于细致。比如都以小孩的照片作为人类进行训练,则推理阶段传入老人的照片,会无法识别。 是把噪声也作为特征进行了学习。
实际上,会将数据集分为两部分,一部分作为训练集,一部分进行评估。当损失量降低,即梯度下降,到一个值后出现上下波动,说明训练完成。实际中往往会更早结束训练,即下降趋于缓和。
收敛
随着训练轮次不断增多,损失会逐渐减小,最终训练集得到的损失会上下波动,即收敛。
而在开始收敛的轮次范围,实际的推理效果损失会随着训练轮次不断增多在之前下降的基础上开始些许增加
PyTorch 基础
张量
张量 Tensor 是包含单一数据类型元素的多维矩阵,不是向量,是 PyTorch 中常用的变量类型,类似 Numpy 中的array。
在向量中,一个数字代表一个纬度,而张量中,数组的维度表示张量的维度
数组与张量间的类型转换 Python list[int] -> numpy array 与 Python list[int] -> PyTorch Tensor
import numpy
import torch
list_int = [[1, 2, 3], [4, 5, 6]]
# [[1, 2, 3], [4, 5, 6]]
# 依然是 python 类型转换写法 `类型名()`
array_int = numpy.array(list_int)  # array 是 numpy 中定义的一个类型
# [[1 2 3]
#  [4 5 6]]
tensor_int = torch.tensor(list_int)  # tensor 是 pytorch 中定义的一个类型
# tensor([[1, 2, 3],
#         [4, 5, 6]])
转换参数
dtype,可在转换成张量时声明张量的数据类型,即张量内元素的类型list_int = [[1, 2, 3], [4, 5, 6]] tensor_int8 = torch.tensor(list_int, dtype=torch.int8) # 每个元素取值范围 -128 ~ 127转换参数
requires_grad=True,该张量是否保留梯度信息。在预测权重时需要反向传播 ,如果需要使用到张量,则张量必须保留梯度信息,即requires_grad=True
张量元素类型转换
tensor_double = tensor_int8.double()  # 将元素类型转换成 double
print(tensor_double.dtype)  # float64
张量的形状
tensor_var.shape或tensor_var.size()特殊的张量
空张量
torch.empty(1, 5)1行5列的全0张量。tensor([0.0000e+00, 0.0000e+00, 0.0000e+00, 0.0000e+00, 0.0000e+00]) # 元素是浮点型全1张量
torch.ones(1, 5)1行5列的全1张量 。二维时可称为全1矩阵torch.tensor([1., 1., 1., 1., 1.]) # 元素是浮点型随机整数张量
torch.randint(,类似random.randint# 传入取值范围与尺寸 torch.randint(low=1, high=10, size={1, 5})指定数据类型的空张量,只需指定尺寸,pytorch会自动填充该类型的 0 元素
torch.FloatTensor(1, 5)
张量对象的常用方法
张量转换为 numpy array
.numpy(一个张量内只有一个元素时获取该元素的值
.item(。得到的是 python 原始类型torch.tensor([[[[[[1]]]]]]).item() # 1 tensor_var = torch.tensor(2.5) # torch.tensor(2.5000) tensor_var.item() # 2.5求最大值
.max(获取全部元素中最大的值
tensor_var.max()维度参数
dim=int可指定比较的维度。注意结果的维度。表示去除多少层[]后,对数组中每一项进行对位比较。关键在于 dim 何时为 0,为 0 时才会对每项进行对位比较。# 二维 tensor_var = torch.tensor([ [6, 3, 4, 8], [1, 9, 6, 7] ]) tensor_var.max(dim=0) # 直接对每项进行对位比较,即取每列中的最大值。即不深入 # torch.return_types.max( # values=tensor([6, 9, 6, 8]), # 第一列最大值是6,第二列最大值是9,依次类推 # indices=tensor([0, 1, 1, 0]) # 进行对位比较时的索引 # ) tensor_var.max(dim=1) # 脱去一层[],即每个一维数组内部的每一项进行对位比较。 # 由于每一项就是 tensor(int), 此时的对位比较就是数字间的比较 # torch.return_types.max( # values=tensor([8, 9]), # 第一个一维数组中的最大值是8,第二个一维数组中的最大值是9 # indices=tensor([3, 2]) # 最大值在一维数组中的索引 # ) # **注意,此处的结果与索引相比原始张量都降了一个维度, 2 -> 1** # 即:结果是每个维度下的比较出最大值,组成一个降一维的张量 # 索引是表示最大所在位置,降一维的张量 # dim=-1 等同与 dim = 1 # 二维的dim取值范围 [-2, 1] # 三维 tensor_var = torch.tensor([ [[6, 3, 4, 8], [1, 9, 6, 7]], [[3, 8, 1, 2], [6, 9, 5, 0]] ]) # dim=0,直接对每一项间进行对位比较 tenosr_var.max(dim=0) # 即矩阵间进行比较。此时取每个位置的最大值 # torch.return_types.max( # values=tensor([ # [6, 8, 4, 8], # [6, 9, 6, 7] # ]), # indices=tensor([ # 最大值在哪一项 # [0, 1, 0, 0], #. [1, 0, 1, 1] # ) # dim=1。深入一层,即每项进行 dim=0 比较 tenosr_var.max(dim=1) # 每个矩阵的dim=0都是1行4列,此处结果就是2行4列 # torch.return_types.max( # values=tensor([ # [6, 9, 6, 8], # [6, 9, 5, 2] # ]), # indices=tensor([ # 最大值在dim=0层数张量的哪一项 # [0, 1, 1, 0], #. [1, 1, 1, 0] # ) tensor_var.max(dim=2) # 脱去2层 `[]`,此时是一维数组,对位比较直接就是数字比较 # torch.return_types.max( # values=tensor([ # [8, 9], # [8, 9] # ]), # indices=tensor([ # 最大值在dim=0层数张量的哪一项 # [3, 1], #. [1, 1] # )求最小值
.min(。与求最大值类似
改变形状
.view(,与numpy.resharp(类似。与原本张量共享内存空间,0拷贝。必须内存连续(.contiguous()可重新整理成连续内存)tensor_var.view(3, 4)将一个包含12个元素的张量转换成3行4列的张量-1。自动推导维度tensor_var.view(3, -1)转换成3行,列数自己计算tensor_var.view(-1)展平为一维张量(常用于全连接层之前)
轴交换
.premut(。指定维度进行转置- 3*4 张量,
tensor_var.premut(1, 0)维度索引 1是4,0是3,因此得到 4*3 张量
- 3*4 张量,
切片。根据张量维度确定切片时
[]内需要多少项。eg,三维张量的切片[:, :, :]- 三维张量进行
[1:,:,:],仅在第一维进行切片。即移除三维数组的第一项 - 三网张量进行
[:, 1:, :],在第二位进行切片。即每一项的一个项被移除了 - 取一维长度为2,二维长度为3的三维张量中的一个元素
[1:, 2:, 3]第二项第三行第四列的元素,得到tensor([[x]])
- 三维张量进行
计算
tensor_var+1每个元素都+1
GPU计算
使用 GPU 进行张量计算,提升运算速度。模型、张量、标注都可以使用 .to(device) 提升速度
# 自动判断可用设备
if torch.cuda.is_available():
    device = torch.device("cuda")  # n卡
elif torch.backends.mps.is_available():
    device = torch.device("mps")  # apple silicon 的 gpu 加速矩阵 Metal Performance Shaders
else:
    device = torch.device("cpu")

tensor_var.to(device)
标准化计算方案
在进行深度学习时,通常需要将训练数据集和推理内容都进行标准化/归一化。
这里以线性回归模型举例。假设一个商品的价格受其“离市中心的距离”和“距离保质期结束的天数”两个因素影响。
此时有两个权重,模型形式为:
误差评估计算为损失函数,比如
在数学上,模型会根据误差对
但在反向传播时,特征的数值量级差异会严重影响权重更新的节奏。例如,距离通常以“米”计(数值在几千到几万),而保质期以“天”计(数值只有几天到几十天): 由于梯度计算是求导,根据求导法则,输入值越大,对应的梯度变化就越剧烈。这会导致
为了避免这种尺度失衡带来的“病态震荡”与收敛困难,需要使用标准化/归一化,将各个特征的数值范围拉回到同一个起跑线(比如均值为 0,方差为 1,或映射到 0~1 之间)。这样能让所有权重在梯度下降时步伐协调一致,大幅提高模型的训练速度与稳定性。
常用 API 介绍
数据准备
MNIST数据集
手写数字识别验证训练 数据集,是深度学习的 hello world,用于检测模型/库/框架是否有效的评价指标
250名美国人的手写数据集,一半是美国的高中学生,一半是美国国家统计局工作人员
共四个压缩包文件,都是图片的二进制并进行了压缩
- train-images-idx3-ubyte.gz - 训练用的图片
- train-labels-idx1-ubyte.gz - 训练用的标签
- t10k-images-idx3-ubyte.gz - 验证用的图片
- t10k-labels-idx1-ubyte.gz - 验证用的标签
使用 pytorch 时无需手动下载,pytorch 提供 api 自动拉取
from torchvision.datasets import MNIST

mnist_train = MNIST(root='./mnist_data/', train=True, download=True)
# 参数说明
# root: str  数据存放目录
# train: bool  是否为训练集
# download: bool  是否下载并放入root路径
# tranform: called  图片转换器函数,将 PIL 图片传入该该函数进行转换,返回转换后的结果(eg: 将图片转换成张量)
# target_tranform: called  目标转换器,将接受的目标进行转换,返回转换后的结果
mnist 数据集的父类是 torch.utils.data.Dataset,可使用len() 获取长度,[]索引获取一个(PIL图片对象, 数字标签的元组。当要训练自己的数据集时,需要替换掉 mnist 数据集,也要继承Dataset。需要实现 __len__ 与 __getitem__ 方法
数据加载器就是基于这两个方法,即获取长度与获取指定索引的对象
数据加载
数据加载器
DataLoader是 PyTorch 中用于批量加载、打乱并供给数据给模型训练的可迭代对象
注意数据加载器只能遍历 tensor/numpy arrays/numbers/dicts/lists
from torch.utils.data import DataLoader

loader = DataLoader(dataset=mnist_train, batch_size=1, shuffle=True)
参数详解:
- dataset: 加载的数据集对象(需继承自 torch.utils.data.Dataset)
- batch_size: 每次迭代送给模型的样本数量(批次大小)
- 值大小的影响:较小的批次梯度噪声大,但有一定正则化效果;较大的批次能充分发挥 GPU 的并行计算性能,大幅缩短训练耗时。通常选取 32、64、128、256 等,GPU 甚至可设置为1024,根据计算单元数、显存、数据集的张量形状等多方面确定
- 常见误区:batch_size=1 是纯随机梯度下降(SGD),数学上完全可以收敛。若训练中报“样本数不能为 1”的错误,通常是因为模型中包含了批归一化层(BatchNorm),其在训练时必须至少有 2 个样本才能计算方差,并非 DataLoader 本身的限制
- shuffle: 是否在每个 Epoch 开始前打乱数据顺序。训练集建议设为 True 以防止模型按顺序死记硬背;验证/测试集通常设为 False
- num_workers: 用于数据加载的多进程数(默认为 0,表示由主进程加载)。在 Windows 系统下若大于 0,代码必须包裹在
if __name__ == '__main__':之下,否则会报子进程递归启动错误 - pin_memory: 是否开启锁页内存。开启后(设为
True),数据从 CPU 内存传输到 GPU 显存的带宽速度会显著提高(通常在 NVIDIA 独立显卡上使用) - drop_last: 当整个数据集总数不能被 batch_size 整除时,是否丢弃最后一个不足 batch_size 的批次。如果开启了 BatchNorm 且最后一个批次只剩 1 个样本,建议开启 drop_last=True 防止报错
数据转换
由于数据加载器只支持指定类似,而像 MNIST 中的数据都是 PIL Image对象,数据加载器无法正常遍历。因此实例化数据集对象时需要向 tranform 参数传入函数用于将数据集中的每一项进行转换,转换成数据加载器可以遍历的类型
使用官方提供的转换器。官方提供了一些转换函数位于
from torchvision import tranforms,可直接使用from torchvision import tranforms dataset = MNIST(root='./mnist_data/', train=True, download=True, transform=tranforms.PILToTensor()) # PIL图片转换成张量的转换器(0-255) # tranforms.ToTensor() # 另一中常用图片转换器,转换成 0-1 的 FloatTensor from torch.utils.data import DataLoader loader = DataLoader(mnist_train, batch_size=2, shuffle=True) for images, labels in loader: print(images) # 可正常遍历。将一个 batch 的图片放到一个数组再转成 tensor print(labels.item())一次使用多个转换器。通过
tranforms.Compose将多个转换函数作用在数据集中的每一项。预处理/归一化就可以在此处进行from torchvision import tranforms tranform_pipe = tranforms.Compose([ # 数组内可传入多个转换器 transforms.PILToTensor(), # 此处可进行数据预处理,归一化,使后续交给模型的数据就是已经处理完成可直接使用的数据 ]) dataset = MNIST(root='./mnist_data/', train=True, download=True, transform=tranform_pipe) # 更常见的写法
注意:PyTorch 等框架的数据转换器(如 transforms.ToTensor())在处理图像时,会将通道维度提前,进行轴交换(Transposition)。比如 MNIST 中的单通道灰度图,原始高、宽、通道为
这样设计的历史原因在于:早期的主流框架(如 Caffe、Torch)以及底层的许多卷积算法实现(如早期 cuDNN 与 im2col 矩阵乘法)都优先统一采用 NCHW 作为标准张量接口规范 (Batch, Channel, Height, Width)。因此 PyTorch 在 API 设计上将图像统一转换为通道在前的格式,以确保整套计算图与各类底层算子接口无缝对接。
for i, label in loader:
  print(i.sharp)
  # torch.Size([1, 1, 28, 28])
  # 即:加载器配置的 batch_size, Channel, Height, Width
如何将图片张量转换回 PIL 图片,便于调试时查看?官方提供了torchvision.transforms.functional.to_pil_image函数可直接将加载器加载出的图片张量转换回 PIL 图片。或使用以下步骤手动处理
使用
make_grid移除batch信息。make_grid可以把一批(一个 batch)的图片拼接成一张大画板from torchvision.utils import make_grid ... for i, label in loader: # loader 的 batch_size 为1 print(make_grid(i).sharp) # torch.Size([3, 28, 28]) # 单通道在通道维度上复制 3 遍(广播为 RGB),得到一个3通道的图片张量 # batch size 为 2 时 # torch.Size([3, 32, 62]) # 宽度被拉长了使用轴交换,将通道数放到末尾
tensor_var.permute(1, 2, 0)张量转换成 numpy 数组
tensor_var.numpy()
完整的代码
for i, label in loader:
  image = make_grid(i).permute(1, 2, 0).numpy()
  plt.imshow(image)
  plt.show()
模型
此处主要介绍深度神经网络(在监督神经网络分类下的小部分)。主要种类有
- DNN 传统深度神经网络
- CNN 卷积神经网络
- RNN 循环(递归)神经网络
在网络中,会有很多层,且层也分很多不同的种类,详见官方文档。模型就是选取不同的层进行组合,实现目的
以
torch.nn.Linear全连接层(线性层)为例。像 MNIST 数据集这种简单且样本数据足够多,一个全连接层就有不错的效果from torch import nn class ExampleModel(nn.Module): def __init__(self): super().__init__() # 继承自父类的 init 方法,旧版本中需要 super(本类, self).__init__() self.fc1 = nn.Linear(1*28*28, 100) # 全连接层1, 输出维度 100 self.relu = nn.ReLU() # 激励函数 self.fc2 = nn.Linear(100, 10) # 全连接层2,输出层。需要接受上一层的输出作为输入。输出节点数10,此分类模型需要10个分类 def forward(self, images_tensor): # 图片拍平,以便将数据放入一个层 images_tensor_viewd = images_tensor.view(-1, 1*28*28) # 变成一个二维张量,batch的每张图片都降 1 维,-1 表示自动计算,最终就是 batch_size。图片需要拍平才能交给全连接层 # 前向传播 将数据交给下一层 fc1_out = self.fc1(images_tensor_viewd) # 放入一个层,得到层1的输出 fc1_out = self.relu(fc1_out) # 使用激励函数将层1的输出进行评分与反馈 out = self.fc2(fc1_out) # 层1的输出交给层2 return out
注意,采用全连接层需要将二维张量拍平成一维张量进行计算,每一个神经元,都拥有与输入维度相同数量的独立权重。导致全连接层无法区分哪些像素在物理空间上是紧密相邻的(无论是横向还是纵向相邻),而是盲目地将全局所有像素全量互连,这不仅会导致参数量呈几何级数爆炸,还会极大地增加训练难度和过拟合风险。因此,提取二维图像特征通常使用卷积神经网络(CNN)或 Vision Transformer,而非全连接层
激励函数
又称激活函数,是优化线性计算过程的加速手段。激励函数分为有状态与无状态(上一次传入的值是否影响后续计算),实际规范中,即使是无状态的激活函数,每层的输出也会实例化一个新的激活函数而不是共用一个激活函数实例
有以下一些常见分类
- Sigmoid
- tanh
- Relu
- Leaky ReLU (PReLU)
- ELU
- MaxOUT
容器管道
前向传播中,每次除了最后一层作为输出,每一层都需要将输出传入激活函数,返回值作为该层的输出交给下一层
fc1_out = self.fc1(images_tensor_viewd)
fc1_out = self.relu(fc1_out)
在定义每一层时,可以使用 Sequential 容器管道,将层与激活函数放到一起,实现类似langchain中管道的效果
self.fc1 = nn.Sequential(nn.Linear(1*28*28, 100), nn.ReLU())

# 在前向传播时可直接使用
fc1_out = self.fc1(images_tensor_viewd)
在定义模型时,除了函数式的定义方式(init中定义每一层,forward函数内编写层的先后关系),更可以直接在 init 中使用容器管道将层的定义和先后关系一同写出
# 也可以使用一个管道将整个模型都串起来
self.net = nn.Sequential(
    nn.Linear(784, 256),
    nn.ReLU(),
    nn.Linear(256, 64),
    nn.ReLU(),
    nn.Linear(64, 10)
)
优化器
Optimizer 用于优化模型寻找最优解的过程。 在 torch.optim 中存放了多种优化器使用方法可查看[官方文档](https://docs.pytorch.org/docs/stable /optim.html),常见分类如下
梯度下降:最原始,最基础的算法。通过将所有数据集载入,计算它们的梯度,根据梯度执行决策。即根据 loss 进行运算。 又存在如下分类
- 标准梯度下降(GD)
- 批量梯度下降(BGD)
- 随机梯度下降(SGD)
动量优化
自适应优化
torch.optim.Adam由代码自行决定,使用最为简单from torch.optim import Adam model = MnistModel() # 自适应优化器,实例化时传入模型的参数与学习率即可 optimizer = Adam(model.parameters(), lr=1e-4) # 数值越小学习率越高
损失函数
优化器需要模型计算结果作为依据,通常使用 loss。因此需要设计 loss 的计算方法,统一成一个损失值进行计算,以便得知下一次需要向哪个方向进行权重优化。损失函数位于 torch.nn 内
损失函数的选择取决于模型输出的结论与实际值(数据标注)间的关系。常见的损失函数有以下几种
0-1损失函数(zero-one loss function)
绝对值损失函数
log对数损失函数
平方损失函数
指数损失函数(exponential loss function)
Hinge损失函数
感知损失函数(preceptron loss function)
交叉熵损失函数(Cross-entropy loss function)通过预测值与标注的真实值计算得到损失
均方误差(Mean Squared Error)最简单的损失函数。计算预测值与标注差值的平方
均方根误差
平均绝对误差(Mean Absolute Error)
etc.
目的是让训练结果与标签建立联系。在梯度下降优化器中,让 loss 不断减小的方向就是训练方向
损失函数的使用
from torch.nn import L1Loss
loss_func = L1Loss()  # 实例化损失函数
loss = loss_func(model_output, label)  # 传入模型输出与标签,计算损失值
训练流程
在实际项目中,深度学习训练模型的流程如下
- 数据标注与预处理 - 数据集的实例化
- 数据加载 - 数据加载器的实例化
- 选取模型与优化器 - 模型的编写和实例化,优化器的实例化
- 循环数据集训练
- 训练
- 损失计算
- 模型保存(可选)
将所有数据进行一轮训练称为一个 epoch
MNIST 识别案例
尝试使用 mnist 数据集编写一个手写数字的深度训练模型,训练并测试
训练的准备工作
在实际开发中,训练过程往往非常漫长。可以安装 tqdm,为循环或迭代生成一个进度条并推测剩余时间。 便于查看训练进度
from tqdm import tqdm

original_iter_obj = range(10)  # 待循环的迭代对象
iter_obj = tqdm(original_iter_obj, total=10)  # 将可迭代对象使用tqdm封装并传入总循环次数
for i in iter_obj:
  time.sleep(1)
计算数据标准化参数(此处不进行计算,取 mnist 这个常见数据集已经计算好的标准化参数,均值
与标准差 ) 模型保存与优化器保存
- 模型保存
torch.save(model.state_dict(), path) - 优化器保存
torch.save(optimizer.state_dict(), path) - 模型加载
model.load_state_dict(torch.load(path)) - 优化器加载
optimizer.load_state_dict(torch.load(path))
- 模型保存
torch 的黄金三件套。在循环加载的每个 batch 时,除了模型训练,还需要训练三部曲
- 梯度置0
optimizer.zero_grad()将梯度设置为 0。因为梯度计算累加的,在一个新 batch 中,梯度值是上一个 batch 计算出的值,需要置为 0 方便后续准确计算出当前 batch 的梯度 - 反向传播
loss.backward()计算这个 batch 的梯度 - 单次优化
optimizer.step()根据本 Batch 的梯度更新模型参数
- 梯度置0
各个工具的来源
- 数据源与标注:MNIST torch提供
- 数据加载:DataLoader 类
- 模型选择:单一的全连接层
- 优化器选择:自适应优化器
Adam,学习率 - 损失函数选择:交叉熵损失
训练模型
编写训练代码,使用训练集进行训练
from tqdm import tqdm
import torch
from torch import nn, optim
from torch.utils.data import DataLoader
from torchvision import transforms
from torchvision.datasets import MNIST

# 设备选择 (支持 Mac M 系列芯片加速)
device = torch.device("mps" if torch.backends.mps.is_available() else "cpu")

# 定义转换器供后续数据集使用 - 注意,这里的均值与标准差是在 [0.0,1.0] 尺度下统计出来的
transforms_pipe = transforms.Compose([
  transforms.ToTensor(),  # PIL 图片转 FloatTensor(归一化张量)
  transforms.Normalize(mean=(0.1307,), std=(0.3081,))  # 标准化,需要每个通道的均值与标准差
])

# 训练用的数据集
train_dataset = MNIST(root='./mnist_data/', train=True, download=True, transform=transforms_pipe)

# 数据加载器
loader = DataLoader(train_dataset, batch_size=8, shuffle=True)

# 设计模型结构
class MnistModel(nn.Module):
  def __init__(self):
    super().__init__()
    self.fc = nn.Linear(1*28*28, 10)  # 本模型只使用一个全连接层

  def forward(self, batch_tensor):
    batch_tensor_viewd = batch_tensor.view(-1, 1*28*28)  # 图片拍平,以便将数据放入全连接层。-1 表示 batch_zise 自行计算
    out = self.fc(batch_tensor_viewd)  # 将张量放入层中,得到层的输出
    return out

# 实例化模型
model = MnistModel().to(device)  # 推送到 gpu,默认是 cpu 模式

# 实例化优化器。使用最简单的 Adam 优化器
optimizer = optim.Adam(model.parameters())  # 学习率使用默认参数 1e-3

# 实例化损失函数 - 交叉熵损失
loss_func = nn.CrossEntropyLoss()

# 遍历数据
model.train()  # 开启训练模式。规范:在轮次开头显式声明。虽然实例化的模型默认就是训练模式
total_loss = 0.0   # 累计测试总损失 - 用于计算平均损失,进而查看收敛情况
total_samples = 0  # 累计评估的总样本数
loader = tqdm(loader, total=len(loader))  # 将加载器转化成带进度条的加载器
for images, labels in loader:
  # 数据移至指定设备
  images, labels = images.to(device), labels.to(device)

  # 训练三部曲1 - 梯度置0
  optimizer.zero_grad()

  # 前向传播
  output = model(images)
  loss = loss_func(output, labels)  # 计算损失

  # 查看收敛情况
  total_samples += labels.size(0)  # 统计样本总数
  # epoch 的累计损失 (loss.item() 乘以当前 batch 大小得到该 batch 总损失)
  total_loss += loss.item() * images.size(0)
  loader.set_description(f'loss: {total_loss / total_samples : .6f}')  # 进度条上打印平均损失,会发现逐渐变小,即随着训练逐渐收敛

  # 训练三部曲2 - 反向传播
  loss.backward()

  # 训练三部曲3 - 优化器更新
  optimizer.step()

# 训练完成,保存权重
torch.save(model.state_dict(), './mnist_data/model.pth')  # torch 规范格式
torch.save(optimizer.state_dict(), './mnist_data/optimizer.pth')
评估模型
编写评估代码,加载训练好的权重,使用测试集数据进行测试 。与训练代码类似,但无需优化器和训练的步骤
import os
from tqdm import tqdm
import torch
from torch import nn, optim
from torch.utils.data import DataLoader
from torchvision import transforms
from torchvision.datasets import MNIST

device = torch.device("mps" if torch.backends.mps.is_available() else "cpu")

# 定义转换器供后续数据集使用
transforms_pipe = transforms.Compose([
  transforms.ToTensor(),  # PIL 图片转 FloatTensor(归一化张量)
  transforms.Normalize(mean=(0.1307,), std=(0.3081,))  # 标准化,需要每个通道的均值与标准差
])

# 用的数据集
test_dataset = MNIST(root='./mnist_data/', train=False, download=True, transform=transforms_pipe)

# 数据加载器
loader = DataLoader(test_dataset, batch_size=8)

# 设计模型结构
class MnistModel(nn.Module):
  def __init__(self):
    super().__init__()
    self.fc = nn.Linear(1*28*28, 10)  # 本模型只使用一个全连接层

  def forward(self, batch_tensor):
    batch_tensor_viewd = batch_tensor.view(-1, 1*28*28)  # 图片拍平,以便将数据放入一个层
    out = self.fc(batch_tensor_viewd)  # 将张量放入层中,得到层的输出
    return out

# 实例化模型
model = MnistModel()  # 此时在 cpu 上
model.load_state_dict(torch.load('./mnist_data/model.pth', map_location='cpu'))  # 加载权重并指明加载在 cpu 上
model.to(device)  # 最后统一推送到目标设备 (GPU / MPS / CPU)

# 损失函数
loss_func = nn.CrossEntropyLoss()

# 遍历数据
model.eval()  # 开启评估模式
total_loss = 0.0   # 累计测试总损失 - 用于计算平均损失,进而查看收敛情况
total_correct = 0  # 累计预测正确的样本数
total_samples = 0  # 累计评估的总样本数
with torch.no_grad():  # 声明无需反向传播。关闭自动求导计算图,节省显存与加速推理
  for images, labels in tqdm(loader, total=len(loader)):
    # 数据移至指定设备
    images, labels = images.to(device), labels.to(device)

    # 获取预估结果
    output = model(images)  # batch 中每张图片在每个种类可能性的二维 tensor
    result = output.max(dim=1).indices   # 取每张图的可能性最大值,需要深度一个维度比较。索引刚好就是0-9。或使用 .argmax(dim=1) 等效 .max(dim=1).indices
    # 计算当前 batch 的成功率
    total_correct += predictions.eq(labels).sum().item()  # 统计预测正确的数量
    total_samples += labels.size(0)  # 统计样本总数

    # 计算当前 batch 的损失 - 用于评估是否收敛
    loss = loss_func(output, labels)
    # epoch 的累计损失 (loss.item() 乘以当前 batch 大小得到该 batch 总损失)
    total_loss += loss.item() * images.size(0)

# 最终统计输出 (纯数学严谨统计,避免最后一个batch数量不足batch_size)
avg_loss = total_loss / total_samples
accuracy = total_correct / total_samples
print(f"\n测试集样本总数: {total_samples}")
print(f"平均损失 (Avg Loss): {avg_loss:.4f}")
print(f"测试集准确率 (Accuracy): {accuracy * 100:.2f}%")
已有模型继续训练
将已经训练保存的模型与优化器继续训练。实例化时判断文件是否存在,存在就进行加载即可,其他代码与第一次训练代码不变
# 实例化模型
model = MnistModel().to(device)  # 推送到 gpu,默认是 cpu 模式
if os.path.exists('./mnist_data/model.pth'):
  model.load_state_dict(torch.load('./mnist_data/model.pth', map_location='cpu'))

# 优化器
optimizer = optim.Adam(model.parameters())  # 学习率使用默认值1e-3
if os.path.exists('./mnist_data/optimizer.pth'):
  optimizer.load_state_dict(torch.load('./mnist_data/optimizer.pth', map_location='cpu'))
实际开发中,常用做法是在一次 epoch 完成时就使用测试集进行测试
for epoch in range(3):
    # 1. 训练阶段
    model.train()  # <--- 必须重新切回训练模式!
    for images, labels in train_loader:
        ...
        optimizer.step()

    # 2. 验证阶段
    model.eval()   # <--- 此时模型被切换成了评估模式
    with torch.no_grad():
        for images, labels in val_loader:
            ...
在保存模型时,注意保存效果最好的模型与效果最差的模型
_best_success_rate = 0
_worst_success_rate = 1

...

# 评估结束后,判断评估结果
if avg_loss > _best_success_rate:
	torch.save(model.state_dict(), './mnist_data/best_model.pth')
	torch.save(optimizer.state_dict(), './mnist_data/best_optimizer.pth')
if avg_loss < _worst_success_rate:
	torch.save(model.state_dict(), './mnist_data/best_model.pth')
	torch.save(optimizer.state_dict(), './mnist_data/best_optimizer.pth')
推理
在训练完成后,使用训练出的权重进行推理。推理与评估类似,但无需循环,损失等内容
# 实例化模型
model = MnistModel()
model.load_state_dict(torch.load('./mnist_data/model.pth', map_location='cpu'))
model.to(device)

# 输入转换器,由于输入图片可能是3通道,而我们的模型是单通道训练的。不能使用之前声明的转换器集
input_transforms_pipe = transforms.Compose([
  transforms.Grayscale(1),  # 将图片转换成单通道图片
  transforms.Resize((28, 28)),  # 缩放到 28x28 尺寸
  transforms.ToTensor(),  # PIL 图片转 FloatTensor(归一化张量)
  transforms.Normalize(mean=(0.1307,), std=(0.3081,))  # 标准化,需要每个通道的均值与标准差
])

input_image = Image.open('./inferring.png')
# 【注意】:如果是常见的“白底黑字”真实手写图,必须先反转成 MNIST 的“黑底白字”
# 如果原本就是黑底白字图片,可以注释掉下面这一行
# input_image = ImageOps.invert(input_image.convert('L'))

input_tensor = input_transforms_pipe(input_image)
input_tensor = input_tensor.unsqueeze(0)  # 在索引 0 处增加一个维度,将一张图伪造成一个 batch
input_tensor = input_tensor.to(device)  # 移动到与模型一致的设备上
model.eval()
with torch.no_grad():
  # 将输入交给模型,得到输出
  output = model(input_tensor)
  # 计算出最大的可能性,即为最终推理结果。由于输入被处理成 batch,一样需要 dim=1
  predicted_digit = output.max(dim=1).indices.item()  # indices 刚好就是标注的 0-9
  # 可选:计算预测概率/置信度
  probabilities = torch.softmax(output, dim=1)
  confidence = probabilities[0][predicted_digit].item()

print(f"模型识别结果为: {predicted_digit} (置信度: {confidence * 100:.2f}%)")
注意:PyTorch 中所有的神经网络层在底层算子设计上都是默认接受输入张量的第 0 维度是Batch_Size。为了满足约定需要处理成4 维张量:[Batch_Size, C, H, W]。单张图通过转换器得到的是三维张量 [C, H, W],使用 unsqueeze(0) 在索引 0 处增加一个维度可以很方便的处理成约定格式,从而进行后续步骤
CNN
CNN 即卷积神经网络,相比于普通神经网络,包含了一个由卷积层和子采样层构成的特征抽取器
全连接层在卷积中的作用是分类器。当图片在拍平时,行与行之前的位置关系是模糊的,网络很难理解图片内容,不利于特征的提取
定义一个卷积神经网络的三个基本元素
- 卷积层
- 池化层(可选)- 在低参数模型时,过大的图片需要降低图片分辨率。使用池化层减少图片的空间大小
- 输出层 - 分类情况下可采用全连接层
激活图
在拿到图像后,CNN 使用一个小的权重矩阵(卷积核/过滤器),每次移动一定步长,进行扫描,计算出一个值。最终扫描整张图得到一个扫描计算结果组成的矩阵。该结果称为激活图
- 步长 stride:卷积核每次移动的像素数量。比如为1表示一次移动 一个像素点
- 边界 padding:若直接在图片上使用卷积核扫描,边缘像素的扫描次数少于非边缘像素。通过在图片外围填充数值为 0 的点保证图片边缘像素也保持相同的扫描次数。外围填充的数值即为边界
例如。对于
多过滤
如果有多个卷积核,则每个卷积核进行一次扫描得到一个结果,最终结果也是多个。比如使用10个
若图片为
输出尺寸计算公式
通过每个维度上的输入尺寸
例如一个
- X轴为
- Y轴为
- Z轴为卷积核个数 8
最终激活图的尺寸是
卷积层 API
卷积层的类位于 torch.nn,分为 Conv1D 识别1维(即线),Conv2D 识别2维(常用于图像识别),Conv3D 识别3维(识别立体形状)
下面介绍构建最常用的 Conv2D 时需要传入的常用参数
in_channels: 图片的通道数out_channels: 使用的卷积核数量。按照之前的介绍,输出的通道数与卷积核数量有关kernel_size: 卷积核的大小。通常使用的单数尺寸 stride=1:步长,拥有默认值为1padding=0:填充宽度,拥有默认值为0
输出层
使用池化层简化图片,卷积层提取特征,模型还需要输出层对结果进行输出。对于分类情况,通常使用全连接层作为输出层
CNN 的 MNIST 识别
from torch import nn

class MNIST_CNN(nn.Model):
  def __init__(self):
    super().__init__()
    self.conv = nn.Conv2D(in_channels=1, out_channels=8, kernel_size=(3, 3))  # 卷积层,MNIST 数据集都是单通道,使用8个卷积核,步长与填充使用默认值
    self.relu = ReLU()  # 激励函数
    self.fc = nn.Linear(8*26*26, 10)  # 上一层输出的是 8 通道的 26*26,最终要输出 10 个分类

  def forward(self, images_tensor):
    conv_out = self.conv(images_tensor)  # torch.Size([batch_size, out_channels, 26, 26])
    conv_out = self.relu(conv_out)  # 激励函数
    tensor_viewd = conv_out.view(-1, 8*26*26)  # 激活图拍平,以便后续交给全连接层
    fc_out = self.fc(tensor_viewd)
    return fc_out
ResNet
残差神经网络是一个基于 CNN 的、更为复杂的神经网络模型。
不同深度(层总数)的 ResNet 结构,卷积层1,最大池化层,卷积层2,卷积层3,卷积层4,卷积层5,平均池化层
由于 ResNet 有池化层进行缩略,且卷积层步长为2,不建议过小尺寸的图片使用,理论下限是
由于理论下限,在测试 ResNet 时不能使用 MNIST。可使用 CIFAR10 数据集进行测试。图片是
from torchvision.datasets import CIFAR10


transforms_pipe = transforms.Compose([
  transforms.ToTensor(),
  transforms.Normalize(mean=(0.4914, 0.4822, 0.4465), std=(0.2470, 0.2435, 0.2616))  # 每个通道的均值与标准差
])

train_dataset = CIFAR10(root='./cifar10_data/',train=True, download=True, transform=transforms_pipe)
调用 Pytorch 封装好的 ResNet 的得到实例化模型
from torchvision import models

# 初始化50层的 ResNet
model = models.resnet50(weights=None)  # 不使用预先训练好的模型。预训练模型例如:models.ResNet50_Weights.DEFAULT
修改模型实例的输出层分类数
fc_features = model.fc.in_features
model.fc = nn.Linear(fc_features, 10)  # 将模型中的全连接层修改成 10,即手写数字的 10 个分类
model.to(device)
另一种写法,并支持修改输出层分类数
class MyResNet(nn.Module):
  def __init__(self):
    super().__init__()
    self.resnet18 = models.resnet18(num_classes=10)  # 直接声明模型输出层的分类数

  def forward(self, x):
    return self.resnet18(x)
注意:
使用官方预训练权重(Transfer Learning)时,输入
效果最好。因为卷积核在训练时学到的感受野特征尺度(比如人脸边缘、纹理)是基于这个分辨率的。如果输入分辨率偏差过大,可能会影响预训练特征的识别效果。自行训练 weights=None时,推荐范围均可,甚至可以是非正方形ResNet 主要用于处理3通道图片。如果处理 MNIST 数据集(MNIST 低于下限,不能使用)类似的单通道图片需要额外处理。共两种办法
修改 ResNet 的输入层
model.conv1 = nn.Conv2d(
    in_channels=1,      # 改为 1 通道以适配 MNIST
    out_channels=64,
    kernel_size=7,
    stride=2,
    padding=3,
    bias=False
)
修改转换器将单通道图片扩充成3通道
transforms_pipe = transforms.Compose([
    transforms.Grayscale(num_output_channels=3),  # 强制复制成 3 通道 (伪彩色)
    transforms.ToTensor(),
    transforms.Normalize(mean=(0.1307, 0.1307, 0.1307), std=(0.3081, 0.3081, 0.3081))  # 由于变成3通道,均值与标准差也要按3通道格式传
])
自定义数据集
在实际开发中,我们会需要将自己手头的数据构造成数据集,即自定义数据集,以便进行训练,得到满足特定需求的模型
自定义数据集需要实现以下几个内容
原始数据的预处理。需要指定一个目录,获取目录下的文件。并 建立分类映射表,将标注数据转换为映射表数据。因为输出的tensor实际上是各个位置-索引-的可能性,因此数据集中的标注也需要处理成索引。比如手写小写字母的识别,最终输出的是0-25位置的可能性。 数据集需要将 a-z 的标注修改成 0-25的位置,即索引
继承自 Dataset 类,并实现魔法方法
__len__与__getitem__。__getitem__:打开一项内容,返回数据tensor与标签tensor__len__: 提取目录下文件的数量
预处理的转换器 transforms。在输出每一项数据前,如果有传入转换器,需要使用转换器将数据进行转换
自定义数据集的实现
以下是一个字母数据集的示例。图片是通过4位字母验证码生成的图片, 文件名是明文4位字母,即标注信息。
import os
from PIL import Image
from torch.utils.data import Dataset

class AlphabetDataset(Dataset):
  def __init__(self, root : str, transform=None):
    super().__init__()  # 继承 Dataset 的 init
    self.root = root    # 指定目录
    self.transform = transform  # 接收转入的转换器
    self.mapping = ['a', 'b'....]   # 标注与索引的映射表 - 即索引0会表示字母 ‘a ’
                                    # 已知标注明文获取索引可通过 mapping.index()
                                    # 从而实现标注明文 与索引的双向映射
    # 【性能核心优化】只在初始化时读取一次磁盘文件列表
    valid_extensions = ('.png', '.jpg', '.jpeg')
    self.pic_list = [
      f for f in os.listdir(self.root)
      if f.lower().endswith(valid_extensions)
    ]

  def __len__(self) -> int:
    return len(self.pic_list)  # 直接返回文件列表的长度就是数据集长度

  def __getitem__(self, index: int) -> tuple[Image, list[int]]:
    image = Image.open(self.root + '/' + self.pic_list[index])  # 获取对应索引的数据,即图片对象
    if self.transform:   # 如果在实例化数据集时传入了转换器
      image = self.transform(image)  # 需要将数据使用转换器进行转换
    label = [self.mapping.index(i) for i in self.pic_list[index]]  # 将标注中的每个字母转换成对应的索引
    label = torch.as_tensor(label, dtype=torch.int64)  # 转换成张量
    return image, label
注意:此数据集的每个数据项是4个字母,即 定长图文。因此最终的输出应该是二维 tensor,共4项,每一项是每个位置是哪个字母的可能性。 即输出层需要 4*26 种可行性
计算数据集的标准值
在使用数据集做训练、评估等内容,是需要使用标准化转换器,传入标准值,进行标准化/归一化处理的。因此需要计算出数据集的标准值,即均值与标准差
以下是通用的多通道图片数据集标准值计算函数。每次读取一个batch,保证一定速度且不爆内存
import torch
from torch.utils.data import DataLoader
from tqdm import tqdm

def get_dataset_mean_std(dataset, batch_size=256, num_workers=4):
    """
    通用自适应计算数据集均值与标准差 (支持单通道/多通道/任意尺寸)
    """
    loader = DataLoader(
        dataset,
        batch_size=batch_size,
        shuffle=False,
        num_workers=num_workers
    )

    # 偷看第 1 个样本的通道数
    sample_img, _ = dataset[0]
    num_channels = sample_img.shape[0] if isinstance(sample_img, torch.Tensor) else len(sample_img.getbands())

    channel_sum = torch.zeros(num_channels)
    channel_squared_sum = torch.zeros(num_channels)
    total_pixels = 0

    print(f"检测到输入为 {num_channels} 通道数据,正在多线程统计...")
    for images, _ in tqdm(loader):
        # 确保是浮点张量且在 [0.0, 1.0] 尺度
        if images.dtype != torch.float32:
            images = images.float()
        if images.max() > 1.0:
            images = images / 255.0

        b, c, h, w = images.shape
        total_pixels += b * h * w

        # 批次累加。 dim [batch_size, C, H, W]
        channel_sum += torch.sum(images, dim=[0, 2, 3])  # batch_size, H, W
        channel_squared_sum += torch.sum(images ** 2, dim=[0, 2, 3])

    # 算术均值与标准差公式
    mean = channel_sum / total_pixels
    var = (channel_squared_sum / total_pixels) - (mean ** 2)
    std = torch.sqrt(torch.clamp(var, min=1e-8))  # clamp 防数值误差小于 0

    # 格式化输出 (如果是单通道返回一个浮点数,三通道返回三元组)
    mean_res = tuple(round(v, 4) for v in mean.tolist())
    std_res = tuple(round(v, 4) for v in std.tolist())

    print(f"\n计算结果如下 (可直接复制到 transforms.Normalize):")
    print(f"mean = {mean_res}")
    print(f"std  = {std_res}")
    return mean_res, std_res
常规计算方式
# 初始化 3 个通道的数据容器
np_arr = [[], [], []]
res_mean = [0, 0, 0]
res_std = [0, 0, 0]
for i in tqdm(range(len(dataset))):
    # 将 PIL Image 转换为 numpy 数组,形状为 (32, 32, 3)
    img = np.array(dataset[i][0], dtype=numpy.float32) / 255.0  # 1. 归一化到 [0, 1]
    for j in range(3):
        # 2. 正确按通道切片 [:, :, j],且去掉多余的外层中括号 []
        np_arr[j].append(img[:, :, j])

for i in range(3):
    res_mean[i] = numpy.mean(np_arr[i])
    res_std[i] = numpy.std(np_arr[i])

print("Mean:", res_mean)
print("Std: ", res_std)

# 或直接使用以下代码

# train_dataset.data 的形状是 (50000, 32, 32, 3),值为 0~255 的 uint8
data = train_dataset.data / 255.0  # 缩放到 [0, 1]

# 对前三个维度 (样本数, 高, 宽) 求统计量,保留最后一个通道维度
res_mean = data.mean(axis=(0, 1, 2))
res_std  = data.std(axis=(0, 1, 2))

print("Mean:", res_mean)
print("Std: ", res_std)
定长数据集的训练
以此处的定长字符识别数据集 4 字母验证码图片为例,模型对单个图片的输出应该是二维 tensor,共 4 项,每一项是每个位置是哪个字母的可能性。 即输出层需要 4*26 种可行性
在训练时,模型的输出的结果将是 [batch_size, 4, 26] 的三维张量。计算损失时会使用输出结果与标注信息,标注信息是 [batch_size, 4] 的二维张量
对于交叉熵损失函数,标注信息需要为一维张量。定长数据集在训练时,标注信息是二维张量,需要拍平变成一维张量,模型的输出结果也需要降一维。因此本例中可将输出处理做 view(-1, 26),变成 [4 * batch_size, 26] 的二维张量,将标注通过 view(-1)处理成 变成 [4 * batch_size] 的一维张量。
from images, labels in loader:
  optimizer.zero_grad()
  # 传入验证码图片
  output = model(images)  # 得到多个字母的输出
  # 定长字符识别数据集的处理
  # output = output.view(batch_size*4, 26)  # 降维,变成多个单字母识别的概率张量
  output = output.view(-1, 26)  # 防止最后一个 batch 数量不足
  # labels = labels.view(4*batch_size)  # 拍平,变成多个单字母的标注
  labels = labels.view(-1)  # 防止最后一个 batch 数量不足
  # 后续不变
  loss = loss_func(output, labels)  # 计算损失
  ...
此时若 batch_size = 1,这样可让标注的每个字母,对应着 26 字母的识别情况。
在 PyTorch 看来,相当于把整个 Batch 视为了
定长数据集的推理
# 将验证码图片打开 - 与之前一样
input_image = Image.open('./inferring.png')
input_tensor = transforms_pipe(input_image)  # 验证码图片格式统一,使用训练时的转换器即可
input_tensor = input_tensor.unsqueeze(0)  # 在索引 0 处增加一个维度,将一张图伪造成一个 batch
input_tensor = input_tensor.to(device)  # 移动到与模型一致的设备上

# 推理
model.eval()
with torch.no_grad():
  # 将输入交给模型,得到输出
  output = model(input_tensor)
  # 降维成 4 个字母的输出
  output = output.view(4, 26)
  # 计算出最大的可能性,即为最终推理结果
  result = output.max(dim=1).indices  # 由于输入被处理成 batch,一样需要 dim=1。再获取索引
  # 将得到的索引通过映射转换回字母
  predicted_chars = [mapping[i] for i in list(result.tolist())]  # 转换成 list 从而使用列表推导式

  # 可选:正确计算 4 个字符的置信度
  probabilities = torch.softmax(output, dim=1)
  # 取出每个字符预测出的最大概率值
  char_probs, _ = probabilities.max(dim=1)
  # 计算 4 个字符的平均置信度
  confidence = char_probs.mean().item()

print(f"模型识别结果为: {predicted_chars} (平均置信度: {confidence * 100:.2f}%)")
for char, prob in zip(predicted_chars, char_probs.tolist()):
    print(f"字符 '{char}' 置信度: {prob * 100:.2f}%")
RNN
全连接层把输入看作一个扁平且无序的静态向量,因此用于同一个样本内部的不同特征/片段 之间完全没有关系的情况。而同一个序列样本内部、时间或顺序上先后出现的元素,如一句话中的前一个词与后一个词,或时序数据中的前一秒与后一秒,这种往往是有关联的。因此需要根据前后信息,处理序列问题,产生了循环神经网络 RNN
最简单的RNN 由输入层,一个隐藏层,输出层构成。隐藏层通过循环,进行样本内前后片段的关联
X层作为输入层,经过 S 层,最终到达输出层 Y
输出层的节点计算:
而 S 层的节点数值与上一轮有关:
除了文字处理等 RNN 常用场景,在图片中,可按照一定宽度,纵向切分,进行 RNN 训练,实现每个小块包含前面所有小块的特征
LSTM
因此出现了长短时记忆网络 LSTM, 缓解了RNN中梯度消失与梯度爆炸的问题
梯度消失与梯度爆炸
梯度消失,即 Vanishing Gradient。在反向传播过程中,对梯度求解会产生 sigmoid 导数和参数的连乘。sigmoid 导数的最大值是 0.25。
若权重的取值范围在 0-1之间。多层时会产生多个 0 - 0.25 的特征值或导数乘积连乘,导致靠近输入层的梯度机会为 0,得不到更新
如果特征值乘积 >1。连乘后数值指数级膨胀,这就是梯度爆炸
LSTM 引入了一条独立的、穿过所有时间步的“信息高速公路”——细胞状态(Cell State, CtCt),让梯度几乎无衰减、无阻碍地从第 100 步直接传回第 1 步,结构上极大地解决了长距离依赖中的梯度消失问题
对于梯度爆炸,可使用梯度裁剪(Gradient Clipping),把梯度的整体范数截断到一个固定的安全上限
loss.backward()

# 核心防爆盾:当梯度范数超过 1.0 时强制按比例等比缩小
torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)

optimizer.step()
LSTM的用法
调用 Pytorch 封装好的 LSTM 的得到实例化模型
torch.nn.LSTM(
	# 重要的参数
  input_size,           # 输入尺寸
  hidden_size,          # 隐藏层尺寸 / 输出的尺寸
  num_layers: int,      # 使用多少层的 RNN
  batch_first: bool,    # 传入数据的维度是否需要将batch_size提前
  bidirectional: bool,  # 是否是 BLSTM 模型。
                        # 由于后面的项包含之前项的信息,前面的项包含信息少,后面的项包含信息多
                        # 再反向累加一遍,实现前后项信息大小均匀
)
向 LSTM 模型输入图像数据的规则。以
- time sequence:时序。对图像来说由于是纵向切分,即切分出来的分片数量
- 此处传 50,说明每个小分片宽度 1 px(实际中若图片较大,不推荐 1px 切分,丢失横向特征,且 time sequence 过多会导致前后关联关系变弱和训练速度极慢)
- 此处传 50,说明每个小分片宽度 2 px。注意交给模型时需要拍平
- batch_size:遍历数据集的 batch_size
- input_size: 图片切分出的每个块的展开后的一维向量长度。按照 time sequence 50,则每个块的高度为 50,宽度为 1。若图片为单通道,input_size 是
,若为三通道则 input_size 是
如果 batch_first=True ,则输入顺序是 batch_size,time sequence,input_size
实例化参数
# 参数说明
# input_size    # 通道数 * 分片的像素个数
# hidden_size   # 隐藏状态向量。是 LSTM 要输出的神经元个数,可以设置为分类结果个数直接得到分类结果
                # 内部记忆特征的维度 (超参数,常取 64/128/256 等,决定特征容量
                # 可设置256等大值增加特征容量,随后在实例后方添加 fc 层得到最终的分类结果输出
# num_layers    # 循环层数,越多越慢
# bidirectional # 为 True 时,输出结果为 hidden_size * 2


class ImageLSTM(nn.Module):
    def __init__(self, input_size, hidden_size, num_classes, num_layers=1, bidirectional=False):
        super().__init__()

        # 参数详解:
        # input_size:    每个时间步输入的特征维度 (如: 通道数 * 切片高 * 切片宽)
        # hidden_size:   LSTM 内部记忆特征的维度 (超参数,常取 64/128/256 等,决定特征容量,并非类别数 )
        # num_layers:    垂直堆叠的 LSTM 层数 (默认为 1,层数越多模型越深越慢)
        # bidirectional: 是否启用双向 LSTM。若为 True,特征维度翻倍 (hidden_size * 2)
        self.lstm = nn.LSTM(
            input_size=input_size,
            hidden_size=hidden_size,
            num_layers=num_layers,
            batch_first=True,  # 推荐设为 True,使输入输出形状为 [batch_size, seq_len, ...]
            bidirectional=bidirectional
        )

        # 分类输出层:负责将 LSTM 提取的高维特征映射到最终的分类类别数
        num_directions = 2 if bidirectional else 1
        self.fc = nn.Linear(hidden_size * num_directions, num_classes)

    def forward(self, x):
        # 假设 x 的形状为: [batch_size, seq_len, input_size]
        out, (hn, cn) = self.lstm(x)

        # 通常取出最后一个时间步的特征进行整图分类: out[:, -1, :]
        last_time_step_feature = out[:, -1, :]  # 比如 mnist。最后一个时序的特征包含前面所有的特征

        # 通过全连接层得到最终各类别的得分 (Logits): [batch_size, num_classes]
        logits = self.fc(last_time_step_feature)
        return logits
训练
# 假设 batch_size=8, 通道3, 高50, 宽100
images = torch.randn(8, 3, 50, 100)

# 1. 调整维度,把宽切分成: seq_len (50) 块,每块宽 (2) px
batch_size, c, h, w = images.shape  # 数据集中遍历的原始数据尺寸 [8, 3, 50, 50, 2]
slice_w = 2  # 设置切分宽度 2px
seq_len = w // slice_w  # 计算时序(切分个数)

x = images.view(batch_size, c, h, seq_len, slice_w)  # 按照目标个数进行切分

# 2. 交换轴,把时序维度 seq_len 移到前面: [8, 50, 3, 50, 2]
x = x.permute(0, 3, 1, 2, 4).contiguous()

# 3. 【核心步骤】:必须通过 view 拍平每个切块的特征!
# 拍平成 [batch_size, seq_len, input_size]
# 此处 input_size = 3 * 50 * 2 = 300 (通道数 * 分片的像素个数)
x = x.view(batch_size, seq_len, c * h * slice_w)

print(x.shape)  # 输出: torch.Size([8, 50, 300])

# 4. 完美送入 nn.LSTM(input_size=300, hidden_size=128, batch_first=True)
不定长数据集
不定长数据集需要对存在不确定信息长度的内容进行识别,比如不定产验证码,OCR 等,包含的内容长度不确定
由于单独使用 LSTM(CRNN)进行处理的效果不是很好,于是先用卷积提取一次特征(下采样,每列特征向量天然聚合了周围一定区域的上下文),在此基础上,使用 LSTM 读取时序(得到经过深度抽象的高层特征,而不是简单的一个向量),实现不定长信息的识别。即 传统 OCR 解决方案 CRNN
此时需要考虑几个问题:
- 使用卷积进行下采样,得到的特征数量不能小于吐出的结果数。防止下采样造成的内容丢失
- 以
的图片为例,ResNet 中 经过第2层卷积输出 ,经过第3层卷积输出 ,第4层卷积输出 ,第5层卷积输出 - 若经过完整的5层卷积计算,即后续传入 LSTM 最多只有 7 个时序。此时若图片中包含元素超过 7,则出现了内容丢失
- 在实际中会移除 ResNet 最后的池化层与第5层甚至第4层的卷积,以便保留足够多的特征信息
- 实际中卷积时为了保留足够的时序,会考虑非对称卷积/池化。即纵向采用激进下采样(缩小倍数高),横向温和下采样(通常只缩小 2 倍或 4 倍)。或修改步长的方式,纵向步长大,横向步长小,比如
stride = (2, 1)(高减半,宽不变!)。这样既压缩了数据量,又为 LSTM 保留了极长的时序长度。此时,纵向的特征在卷积层(CNN)处理的过程中,就已经被完全提取并“浓缩编码”进了通道维度(Channels)中,LSTM只需要根据 CNN 提供的特征切片在横向时间线上进行逻辑推理
- 以
- 卷积输出结果的形状与原始内容的形状不一致,需要处理才能传递给 LSTM
- LSTM 的输出内容如何处理与损失计算
因此此处介绍如何使用 ResNet + LSTM 的方式进行不定长数据集训练与识别。
数据集代码实现
数据集内容是数学计算的图片验证码识别,例如 10 - 8 ,正确结果应该为 2
from torch.utils.data import Dataset

class MathCaptchaDataset(Dataset):
  def __init__(self, root: str, transform=None):
    super().__init__()  # 继承 Dataset 的 init
    self.root = root    # 指定目录
    self.transform = transform  # 接收转入的转换器
   	self.mapping = [i for i in '_0123456789加减乘+-*']   # 空白占位符所用符号(自选符号,一般放在第一位) 与 验证码图片中会出现的所有内容
    valid_extensions = ('.png', '.jpg', '.jpeg')
    self.pic_list = [
      f for f in os.listdir(self.root)
      if f.lower().endswith(valid_extensions)
    ]

  def __len__(self) -> int:
    return len(self.pic_list)

  def __getitem__(self, index: int) -> tuple[Image, list[int]]:
    image = Image.open(os.path.join(self.root, self.pic_list[index]))
    if self.transform:
      image = self.transform(image)
    label = [self.mapping.index(i) for i in pic_list[index]]
    # CTCLoss 天然支持变长标签,不需要人工 Padding。以下是人工 padding 的流程
    # 由于标注是不定长的,需要归一化,以最大长度为基准,对长度不满足的,前方补0表示空
    # for i in range(9-len(label)):  # 最长度为 4 位数间的计算,所以为9
    #   label.insert(0, 0)
    label = torch.as_tensor(label, dtype=torch.int64)
    return image, label
模型的实现
按照之前的内容,由于需要魔改 ResNet,移除后几层,可以在网上找一份手写的 ResNet 代码进行修改。这里使用容器管道,将 Pytorch 封装 ResNet18 中用到的层抽出来作为一个新的模型层
import torch
import torch.nn as nn
from torchvision import models

class MathCaptchaCRNN(nn.Module):
    def __init__(self, img_h=32, num_classes=17, hidden_size=256):
        """
        :param img_h: 固定的输入图片高度 (如 32)
        :param num_classes: mapping 映射表字符总数 (含 CTC Blank 占位符)
        :param hidden_size: LSTM 隐藏层神经元数
        """
        super().__init__()

        # 1. 直接复用官方 ResNet18 骨干,不需要自己手写 BasicBlock
        base_resnet = models.resnet18(weights=None)

        # 截取 layer3 之前的卷积部分 (移除末尾的 layer4, avgpool, fc)
        self.backbone = nn.Sequential(
            base_resnet.conv1,
            base_resnet.bn1,
            base_resnet.relu,
            base_resnet.maxpool,
            base_resnet.layer1,
            base_resnet.layer2,
            base_resnet.layer3  # 输出通道为 256,高宽缩小为原图的 1/16
        )

        # 2. 精确计算 LSTM 输入特征尺寸
        # 经过 4 次步长为 2 的下采样,高度变为 img_h // 16
        feature_h = img_h // 16
        input_size = 256 * feature_h

        # 3. 双向 LSTM 建模时序
        self.lstm = nn.LSTM(
            input_size=input_size,
            hidden_size=hidden_size,
            num_layers=1,
            bidirectional=True,
            batch_first=False  # CTCLoss 默认喜欢 [seq_len, batch_size, num_classes]
        )

        # 4. 分类全连接层 (双向 LSTM 最后一维为 hidden_size * 2)
        self.fc = nn.Linear(hidden_size * 2, num_classes)

    def forward(self, x):
        # 传入值 x 的初始尺寸: [batch_size, 3, H, W]
        feat = self.backbone(x)  # 得到: [B, 256, H/16, W/16]

        B, C, H_feat, W_feat = feat.shape

        # 将时序维度 W 提到第 0 维,得到: [W_feat, B, C, H_feat]
        feat = feat.permute(3, 0, 1, 2).contiguous()

        # 拍平特征向量,得到 LSTM 期望的: [seq_len(W), batch_size, input_size(C*H)]
        feat = feat.view(W_feat, B, C * H_feat)

        # 送入 LSTM: 输出尺寸为 [W_feat, B, hidden_size * 2]
        lstm_out, _ = self.lstm(feat)  # 返回输出结果与反向传播

        # 映射到字符类别: nn.Linear 自动作用于最后一维(虽然全连接层只接受2维,但会自动处理高维张量传入并将输出结果还原成高维)
        # 输出尺寸为: [W_feat, B, num_classes]
        out = self.fc(lstm_out)

        return out
CTCLoss
由于输出结果与时序有关。假设一张图片中包含3个字母,模型识别后可能会输出10个结果,其中3个为识别出的内容,剩余7个为 空白符(Blank token)。而正确的标注是3个字母。此时模型的输出与标注不完全一致,一般的损失函数无法计算。此时需要使用连接时序分类损失 CTCLoss 进行损失计算
关于空白占位符 Blank token
考虑识别单词 "SEE"(有连续相同的字母 e):因为时序切分很细,一个字符往往横跨连续 2~3 个时间步。
如果没有空白符,连续输出 s-s-e-e-e,模型坍缩去重(Collapse)后会变成 "se";
而有了 Blank 机制,模型可以输出 s-s-e-e-_-e-e,去重后就能准确恢复出 "see"!
连接时序分类损失 CTCLoss 不用强制对齐标签且标签可变长,仅需输入序列和监督标签序列即可进行训练
在文字识别、验证码识别、手写数字识别,语音识别等涉及时序的场景,最经典的选择就是 CRNN + CTCloss
Pytorch 封装好的 CTCloss
import torch
import torch.nn as nn

# 1. 实例化 CTC Loss
# blank 默认为 0,对应 mapping[0] 是 '_'
ctc_loss = nn.CTCLoss(blank=0, zero_infinity=True)  # zero_infinity=True 可防止梯度爆炸出现 inf
# ==================== 参数规范 ====================
# log_probs:      [T, N, C] 的对数概率张量 (必须经过 log_softmax(2))
#                 T: 模型输出的时序长度 (即卷积+LSTM后的宽度 W)
#                 N: batch_size
#                 C: 包含 Blank 字符在内的类别总数 (mapping 长度)
#
# targets:        [N, S] (二维带Padding) 或 [sum(target_lengths)] (一维无Padding展平)
#                 真实标签的字符索引序列。
#                 对与不定长的label,padding 成统一长度后传入二维张量 [N, S]
#                 或拍平组成一维,CTCLoss内部依靠 target_lengths 切分还原出多个不定长 label
#
# input_lengths:  长度为 [N] 的一维整数张量,代表该 Batch 中每个样本的预测时序长度 (通常全为 T)
#
# target_lengths: 长度为 [N] 的一维整数张量,代表该 Batch 中每个样本的真实标签字符数
# =================================================

# 2. 训练步中的损失计算
model.train()
# 假设 output 形状为 [T, N, C]
output = model(images)

# 【核心步骤】:输出内容归一化分值,防止损失函数算出负数 / NaN / Inf。
log_probs = output.log_softmax(2)  # 必须通过 log_softmax 转为对数概率!

T, N, C = output.shape  # 时序,batch_size,分类
# 构造 input_lengths: 形状为 [N],每个值都是 T,并放到与模型相同的设备上(此时labels都有padding成长度 T)
input_lengths = torch.full(size=(N,), fill_value=T, dtype=torch.long, device=output.device)

# 确保 target_lengths 也是一维 long 型张量
target_lengths = labels_lens.to(output.device).long()
targets = labels.to(output.device)

# 计算损失
loss = ctc_loss(log_probs, targets, input_lengths, target_lengths)
收集函数
由于损失函数 CTCLoss 需要传入 batch 中每个 label 的长度以实现多个不定长 label 的输入。使用数据集的 collate_fn 参数,将常规遍历格式 images, labels 进行修改,遍历数据集时得到不同的输出内容
def ctc_collate_fn(batch):
    # batch 是一个列表,里面装了 batch_size 个 (image, label) 元组
    images, labels = zip(*batch)
    # 1. 图片拼成 [Batch_Size, C, H, W]
    images = torch.stack(images, dim=0)
    # 2. 自动统计每个 label 的真实长度 -> target_lengths: [Batch_Size]
    target_lengths = torch.tensor([len(lbl) for lbl in labels], dtype=torch.long)
    # 3. 将变长标签拼接成一维张量 -> targets: [sum(target_lengths)]
    targets = torch.cat([torch.tensor(lbl, dtype=torch.long) for lbl in labels], dim=0)
    # 返回图片张量,拼接拍平的labels,每个label长度的一维张量(用于后续切分出每个 label)
    return images, targets, target_lengths

train_loader = DataLoader(
    train_dataset,
    batch_size=32,
    shuffle=True,
    collate_fn=ctc_collate_fn  # <--- 指定收集函数,解决变长标签如何传入损失函数
)

model.train()
# for images, labels in train_loader:  # 不使用收集函数的常规遍历结果
for images, targets, target_lengths in train_loader:  # 使用收集函数对遍历的输出格式进行修改
    # 移至设备
    images = images.to(device)
    targets = targets.to(device)
    target_lengths = target_lengths.to(device)

    optimizer.zero_grad()

    # 前向传播
    output = model(images)  # 输出形状: [T, N, C]

    # 损失计算流程
    log_probs = output.log_softmax(2)  # 对数概率归一化,防止计算出负数等异常损失值
    T, N, C = output.shape  # 时序, Batch_Size, 类别数
    input_lengths = torch.full(size=(N,), fill_value=T, dtype=torch.long, device=output.device)  # 构造 input_lengths: [N],值全为 T
    # 计算损失 (targets 是一维拍平格式,target_lengths 记录真实长度,内部根据真实长度切分出每个不定长label)
    loss = ctc_loss(log_probs, targets, input_lengths, target_lengths)

    loss.backward()
    optimizer.step()
评估
# 假设 mapping = list('_0123456789加减乘+-*')
# 0 号索引固定为 Blank 占位符 '_'

# 1. 将模型输出由 [T, N, C] 置换为便于按样本遍历的 [N, T, C]
output = output.permute(1, 0, 2)

# 2. 取出每个时间步概率最大的字符索引 (直接使用 argmax 更简洁安全)
# 形状变为: [N, T]
pred_indices = output.argmax(dim=-1)

# 3. 对 batch 中逐个样本解码
for i in range(output.shape[0]):
  # 取出第 i 张图片的预测序列和真实标签 (一维张量)
  sample_preds = pred_indices[i].tolist()  # 转为 Python 列表,从而方便遍历
  sample_target = labels[i].tolist()       # 转为 Python 列表,从而方便遍历

  # 【CTC 解码核心】:groupby 连续去重 + 过滤 Blank (0 号位)
  decoded_indices = [k for k, _ in itertools.groupby(sample_preds) if k != 0]

  # 还原为字符串
  pred_text = "".join([mapping[idx] for idx in decoded_indices])
  # 真实标签还原 (如果标签曾用 0 做过 padding 填充,则过滤掉 0,否则全量保留)
  target_text = "".join([mapping[idx] for idx in sample_target if idx != 0])

  # 打印或比对结果
  is_correct = (pred_text == target_text)
  print(f"样本 {i} | 预测: {pred_text:<10} | 真实: {target_text:<10} | {'✓' if is_correct else '✗'}")
目标检测
目标检测是指识别图像中的物体种类与坐标。即训练集的标注信息,需要包含种类信息与坐标信息。在实际训练时,根据需求决定种类的个数。比如常规的滑块验证码,仅需识别出滑块即可,那么物体分类只有一种,即滑块。
数据标注
数据标注分为两种
- 普通打码
- 目标检测画框框/写特征(一般依托于专业软件)
对于目标检测的位置标注,需要提供左上角与右下角的坐标。实现将目标框起来的效果。即(x的最小值, y的最小值)与(x的最大值, y的最大值)
VOC 数据集
PASCAL VOC 挑战赛是一个世界级的计算机视觉挑战赛。VOC(Vision object classes)是一套检测和识别标准化的数据集。
虽然目前学术界和工业界评测前沿模型(SOTA)的主流标准是 COCO 数据集(支持更小目标、复杂场景及实例分割),但 Pascal VOC 作为经典的第一代标准化检测数据集,因其结构清晰直观,非常适合新手入门。 特别是在训练自己的私有目标检测器时,主流标注工具(如 LabelImg)默认即导出 VOC 的 XML 格式(一图一 XML,直观易改)。相比 COCO 庞大而复杂的单一全局 JSON 文件,VOC 格式更轻量、易调试,配合主流框架自带的格式转换工具,是快速构建自定义检测数据集的最方便选择之一。
目录介绍
VOCdevkit/
└── VOC2007 或 VOC2012
    ├── JPEGImages/          # 存放所有原始图片
    ├── Annotations/         # 存放所有 XML 标注文件
    ├── ImageSets/           # 划分训练集、验证集、测试集的 txt 文件
    │   ├── Main/            # 【目标检测】最常用的划分名单
    │   ├── Segmentation/    # 图像分割任务的划分名单
    │   ├── Layout/          # 人体姿态/布局任务的划分名单
    │   └── Action/          # 人体动作识别任务的划分名单
    ├── SegmentationClass/   # 语义分割标签图 (按类别涂色的 PNG)
    └── SegmentationObject/  # 实例分割标签图 (按不同独立目标涂色的 PNG)
位置标注
以滑块缺口为例。可使用 LabelImg、AnyLabeling 等开源工具,对图片进行位置标注,导出 VOC 数据集
- 待标注图片存放到 /path/to/CustomVOC/JPEGImages/
- 明确目标检测的分类。对于滑块,分类只有一个,识别出缺口的位置
- 将标注数据导出到 /path/to/CustomVOC/Annotations/ 。导出的类型是 Pascal VOC
也可使用以下脚本进行数据标注(AI生成脚本,不清楚来源)
import os
import cv2
import xml.etree.ElementTree as ET

# 1. 配置路径
BASE_DIR = "/path/to/CustomVOC"
IMG_DIR = os.path.join(BASE_DIR, "JPEGImages")
ANN_DIR = os.path.join(BASE_DIR, "Annotations")
CLASS_NAME = "gap"  # 目标检测分类:缺口

os.makedirs(ANN_DIR, exist_ok=True)

def save_voc_xml(img_name, img_w, img_h, bbox):
    """生成标准 Pascal VOC 格式的 XML"""
    xmin, ymin, xmax, ymax = bbox
    xml_path = os.path.join(ANN_DIR, os.path.splitext(img_name)[0] + ".xml")

    annotation = ET.Element("annotation")
    ET.SubElement(annotation, "filename").text = img_name

    size = ET.SubElement(annotation, "size")
    ET.SubElement(size, "width").text = str(img_w)
    ET.SubElement(size, "height").text = str(img_h)
    ET.SubElement(size, "depth").text = "3"

    obj = ET.SubElement(annotation, "object")
    ET.SubElement(obj, "name").text = CLASS_NAME
    ET.SubElement(obj, "difficult").text = "0"

    bndbox = ET.SubElement(obj, "bndbox")
    ET.SubElement(bndbox, "xmin").text = str(int(xmin))
    ET.SubElement(bndbox, "ymin").text = str(int(ymin))
    ET.SubElement(bndbox, "xmax").text = str(int(xmax))
    ET.SubElement(bndbox, "ymax").text = str(int(ymax))

    tree = ET.ElementTree(annotation)
    tree.write(xml_path, encoding="utf-8", xml_declaration=True)
    print(f"已保存: {xml_path}")

# 2. 遍历图片进行标注
img_list = sorted([f for f in os.listdir(IMG_DIR) if f.lower().endswith(('.png', '.jpg', '.jpeg'))])

for img_name in img_list:
    xml_file = os.path.join(ANN_DIR, os.path.splitext(img_name)[0] + ".xml")
    if os.path.exists(xml_file):
        continue  # 已标注则跳过

    img_path = os.path.join(IMG_DIR, img_name)
    img = cv2.imread(img_path)
    if img is None:
        continue
    h, w, _ = img.shape

    # 使用 OpenCV 原生 GUI 框选 (按住鼠标左键拉框,按 SPACE/ENTER 保存,按 C 取消,按 ESC 退出)
    rect = cv2.selectROI(f"Annotating: {img_name} (Space: Save, ESC: Exit)", img, fromCenter=False, showCrosshair=True)

    # rect 返回格式为: (x, y, w, h)
    rx, ry, rw, rh = rect
    if rw > 0 and rh > 0:
        bbox = (rx, ry, rx + rw, ry + rh)
        save_voc_xml(img_name, w, h, bbox)
    elif rect == (0, 0, 0, 0):
        # 用户直接按了 ESC 退出
        break

cv2.destroyAllWindows()
目标检测框架 Yolo
Yolo 基于 Pytorch 实现。在物体检测时,使用回归问题求解,基于单独的 end-to-end 网络,实现从原始图像输入到物体的位置与类别的输出
Yolo 借鉴了 GoogLeNet 分类网络结构(与 ResNet 类似, CNN 网络结构),底层依旧以 CNN 模块(如 C3k2 卷积块)为主干,但在关键特征汇聚节点融合了轻量级注意力组件(如 C2PSA 注意力机制),兼顾了 CNN 的极速推理与全局感受野
使用 uv add ultralytics 安装 Yolo 的依赖 。以下是使用方法
生成训练集:直接用 LabelImg 标成 YOLO
切换左侧保存格式为 YOLO;
框选缺口,标签名写 gap;
导出的结果就是一个个类似 0 0.4521 0.6123 0.1250 0.1420 的 .txt 文件。
<class_id> <x_center> <y_center> <width> <height>- class_id:分类的索引(从 0 开始。比如你的滑块缺口只有 1 类,那么固定写 0)。
- x_center, y_center:检测框中心点的坐标。
- width, height:检测框的宽度与高度。
- 【绝对核心】:所有坐标值必须归一化(Normalize)到
区间例如图片宽 、高 ,缺口中心横坐标是 ,那么 x_center
写一个极简的 gap.yaml 文件 :
path: /path/to/my_dataset  # 数据集根目录
train: images/train        # 训练集图片路径 (相对于 path)
val: images/val            # 验证集图片路径 (相对于 path)

# 类别定义 (只有 1 个)
names:
  0: gap
调用 Python 代码直接起跑:
from ultralytics import YOLO

# 加载最新轻量版模型 (如 yolo26n.pt 或 yolo11n.pt)
model = YOLO("yolo11n.pt")

# 一行代码启动训练
model.train(data="gap.yaml", epochs=50, imgsz=320, batch=32, device="mps")
训练过程会自动在当前目录下创建类似 runs/detect/train/weights/ 的目录,并在里面实时维护两个熟悉的权重文件:
- best.pt:在验证集上指标(mAP)最好的那个 epoch 权重;
- last.pt:最近(最后)一个 epoch 的权重(用于意外中断时断点续训)。
编写推理文件
from ultralytics import YOLO

# 1. 加载刚刚训练出来的最好权重
model = YOLO("runs/detect/train/weights/best.pt")

# 2. 对图片进行推理 (支持单张图、图片文件夹、甚至视频和网络摄像头)
# 常用参数:conf (置信度阈值), iou (NMS阈值), device (运算设备)
results = model.predict(  # 内部已经做了 no_grad() 的处理
    source="./test_images/slide_01.png",  # 输入源:可以是图片路径、文件夹、或 PIL/OpenCV 对象。比如 cv2.imread("./slide_01  .png")
    conf=0.25,                            # 置信度阈值 (相当于原来 detect.py 的 --conf-thres)
    device="mps",                         # 指定设备 (mps, cuda:0, 或 cpu)
    max_det=1,                            # 限制最大目标数
    save=True                             # 是否将画好框的图片保存到磁盘 (默认存到 runs/detect/predict/)
)

# 3. 提取推理结果(以你的滑块缺口为例,提取坐标)
for r in results:  # 因为默认是一张图会检测出多结果,所以此处需要遍历
    # 提取所有检测框的像素绝对坐标: [xmin, ymin, xmax, ymax]
       = r.boxes.xyxy.cpu().numpy()
    # 提取置信度
    scores = r.boxes.conf.cpu().numpy()
    # 提取类别 ID
    classes = r.boxes.cls.cpu().numpy()

    for box, score, cls in zip(boxes, scores, classes):
        xmin, ymin, xmax, ymax = box
        # 对于滑块缺口,通常最关心缺口的中心横坐标或左边界
        print(f"检测到缺口: 左边界 xmin={xmin:.1f}, 中心点 x={(xmin+xmax)/2:.1f}, 置信度={score:.2f}")

    # 如果想直接弹窗预览画框图
    # r.show()
轨迹检测
对于识别图片中的曲线轨迹,核心思路是将曲线轨迹识别问题转化为二值语义分割任务。
数据标注与处理
- 标注工具推荐使用折线(Linestrip)或毛刷工具描绘轨迹。若使用多边形(Polygon),需沿轨迹画成带有一定宽度的闭合带状区域。
- 真实细线在进入数据集前,通常需做形态学膨胀(加粗为 3~5 像素宽),并生成存储在 SegmentationClass 目录中的标准单通道 Mask 灰度图(0 代表背景,1 代表轨迹)。
模型选型
- 适合采用对高分辨率细节保留较好的分割架构(首选具有 Skip-connection 的 U-Net,或现代 YOLO-Seg)。
- 训练时需采用 Dice Loss / Focal Loss 以应对极度细长线带来的前景与背景面积失衡。
轨迹重建(必备后处理)
分割模型的输出仅为像素连通域(无序二值掩膜)。
必须通过**骨架细化(Skeletonization)与样条插值/拓扑排序(Spline/Graph Search)**算法,将像素掩膜重新提取还原为包含起终点、走向的连续有序坐标序列
。
图像分割实现流程
这套路线在医学(如视网膜血管检测)、工业质检(如路面裂缝检测)、自动驾驶(如车道线分割)中非常成熟,其标准技术链路如下:
数据标注与加粗(Dilation)
标注时使用折线(Linestrip)描绘轨迹骨架;
在生成标签 Mask 图时,人为用 OpenCV 进行“膨胀(Dilation)”,把 1 个像素宽的轨迹加粗成 3~7 个像素宽的带状线
# 将单像素骨架膨胀成有一定宽度的 Mask,更利于卷积学习
import cv2
mask_dilated = cv2.dilate(skeleton_mask, cv2.getStructuringElement(cv2.MORPH_RECT, (5, 5)))
把加粗后的 Mask 存入 SegmentationClass(灰度图,0 为背景,1 为轨迹)。
模型选型与损失函数调优
模型推荐:
- 传统的 U-Net(由于其跳跃连接保留了极致的浅层高分辨率特征,是细长纹理分割的绝对王者);
- 或现代轻量分割网络(如 YOLO11-seg、DeepLabV3+)。
损失函数:不能用纯 CrossEntropy,必须搭配 Dice Loss 或 Focal Loss,专门惩罚极度样本不均衡。
后处理——将分割结果还原成真正的“轨迹序列”(关键一步): 推理出一张带状 Mask 后,通过算法还原为有序的坐标序列
import numpy as np
from skimage.morphology import skeletonize

# 1. 对模型输出的 Mask 进行细化(骨架提取),重新把粗线压回 1 像素宽的单线骨架
binary_mask = (output_mask > 0.5).astype(np.uint8)
skeleton = skeletonize(binary_mask)  # 得到单像素中心线

# 2. 提取骨架上所有像素坐标
y_coords, x_coords = np.where(skeleton > 0)
points = np.column_stack([x_coords, y_coords])

# 3. 按走向进行拓扑排序或 B 样条曲线拟合 (从起点平滑连接到终点)
# 最终输出真实可用的轨迹点列表: [(x0, y0), (x1, y1), ...]